Strategi AI Inference NVIDIA: Feynman + LPU, Menghalangi Jalan ASIC?
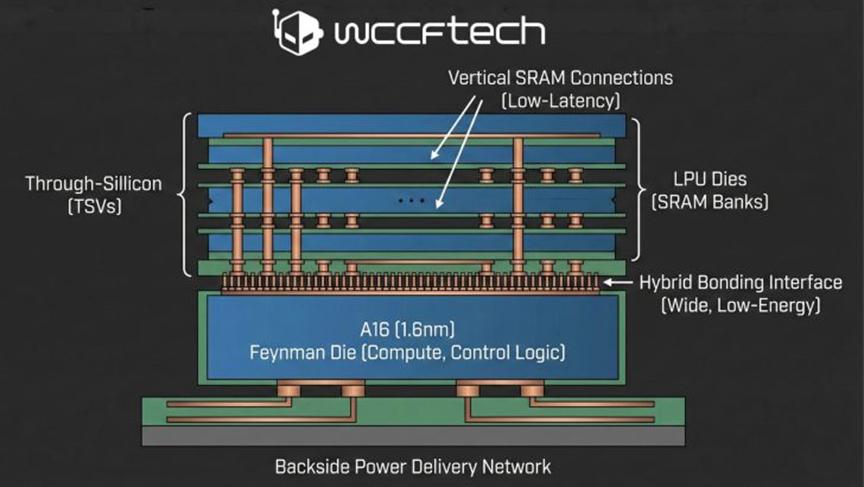
NVIDIA berencana mendominasi tumpukan inference AI dengan GPU Feynman generasi berikutnya, mengintegrasikan unit LPU Groq. Menurut ahli GPU AGF, LPU kemungkinan akan ditumpuk pada chip Feynman menggunakan teknologi SoIC hybrid bonding TSMC, mirip dengan CPU AMD X3D yang menumpuk 3D V-Cache.
Keunggulan utama: LPU dilengkapi SRAM on-chip besar, memungkinkan inference latensi rendah dan pemanfaatan model floating-point tinggi (MFU), sementara HBM tetap digunakan sebagai memori kapasitas. Hal ini memberi NVIDIA keunggulan signifikan dalam decoding dan tugas inference latensi rendah, sekaligus membatasi peluang kompetitor ASIC.
Untuk menghindari masalah antitrust, NVIDIA tidak mengakuisisi Groq secara langsung, melainkan menandatangani lisensi IP non-eksklusif, mendapatkan hak penggunaan teknologi LPU. Strategi “reverse acquisition” ini mirip dengan metode Microsoft sebelumnya dalam menyerap talenta dan IP startup tanpa terkena pengawasan regulator.
Singkatnya, kombinasi Feynman + LPU dapat meningkatkan kemampuan inference AI NVIDIA ke level baru, sekaligus membuat kompetitor ASIC sulit mengejar.